报告日期:2021年11月25日
★基本面数据整理:
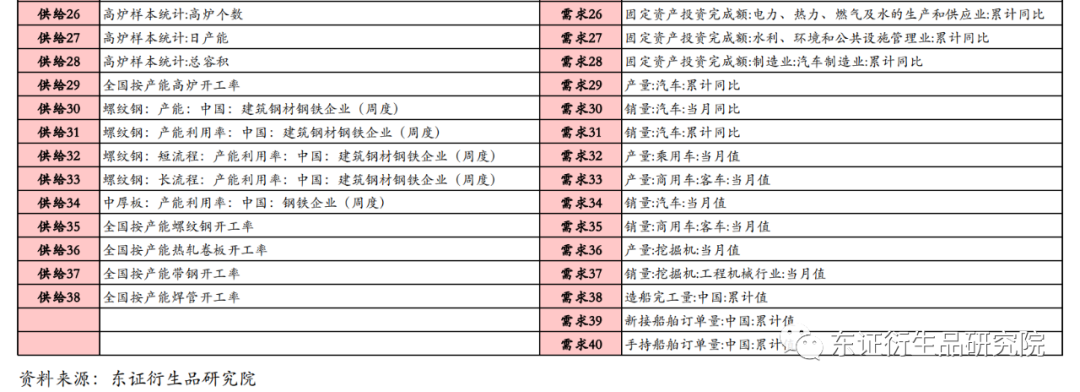
基于螺纹钢上下游产业链关系,共选取4大类,共121个基本面数据,包括供给类,需求类,库存类以及宏观类。对原始数据进行去极值,标准化,差分,数据可得性调整,频率调整等处理,作为模型的输入因子。
★降维与模型选择:
PCA降维:对于数据进行主成分降维,以可解释性方差为依据截取95%的信息度,将121个因子降维至30个因子;
OLS多元回归: 利用普通最小二乘法进行多元回归,最优拟合曲线应该使各点到直线的距离的平方和(残差平方和RSS)最小;
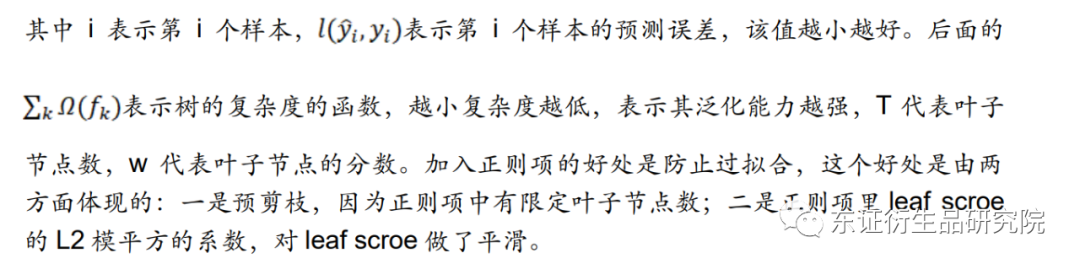
XGBoost模型: 基于传统GBDT模型,将目标函数泰勒展开到了二阶,并且加入了叶子权重的L2正则化项;
RNN(LSTM)模型:具有记忆功能的循环神经网络,当前隐藏层的状态受到之前隐藏层状态的影响。
★模型结果:
综合模型回测结果达到2017年至今累计收益率233.53%,年化收益率29.74%,年化波动率13.16%,夏普值2.08,最大回撤-10.07%,胜率56.05%,平均持仓时间14.22天。
★致谢:
感谢东方证券金融工程首席分析师朱剑涛老师的指导与帮助。
★风险提示:
市场风格的变换会造成特征有效性变化,导致模型效果下降。
1.1、商品基本面量化原理
基本面量化试图有效地结合“基本面研究”和“量化投资”两套独立而成熟的交易理论——以大量的基本面数据为基础对未来价格做出预测,并自动生成有效的交易信号,不仅遵从基本面研究的严谨逻辑,又兼具量化交易的高效分析。具体而言,在本研究报告中,以螺纹钢的基本面数据作为输入,通过模型对未来价格进行预测,接着根据预测价格生成相应的多空信号进行交易。
1.2、螺纹钢基本面因子选取
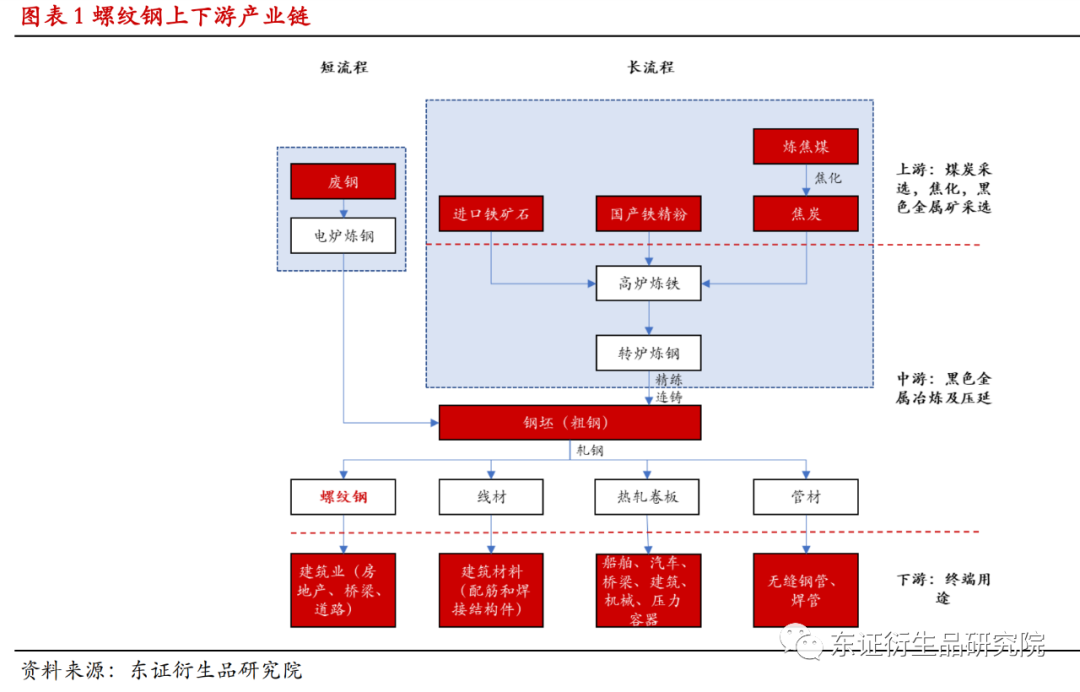
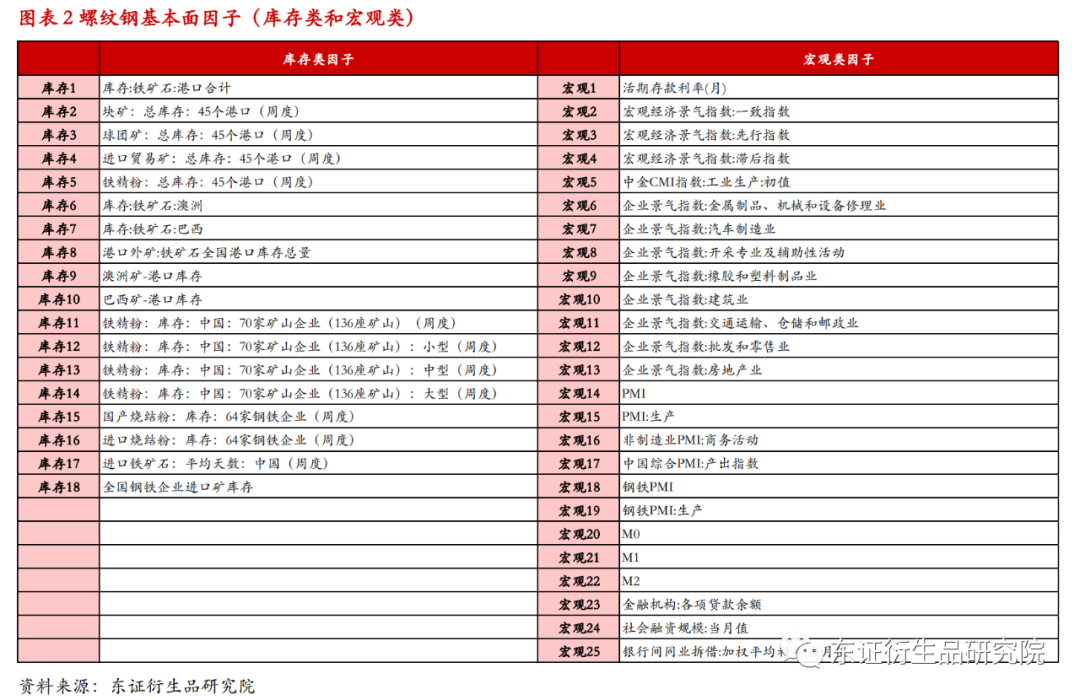
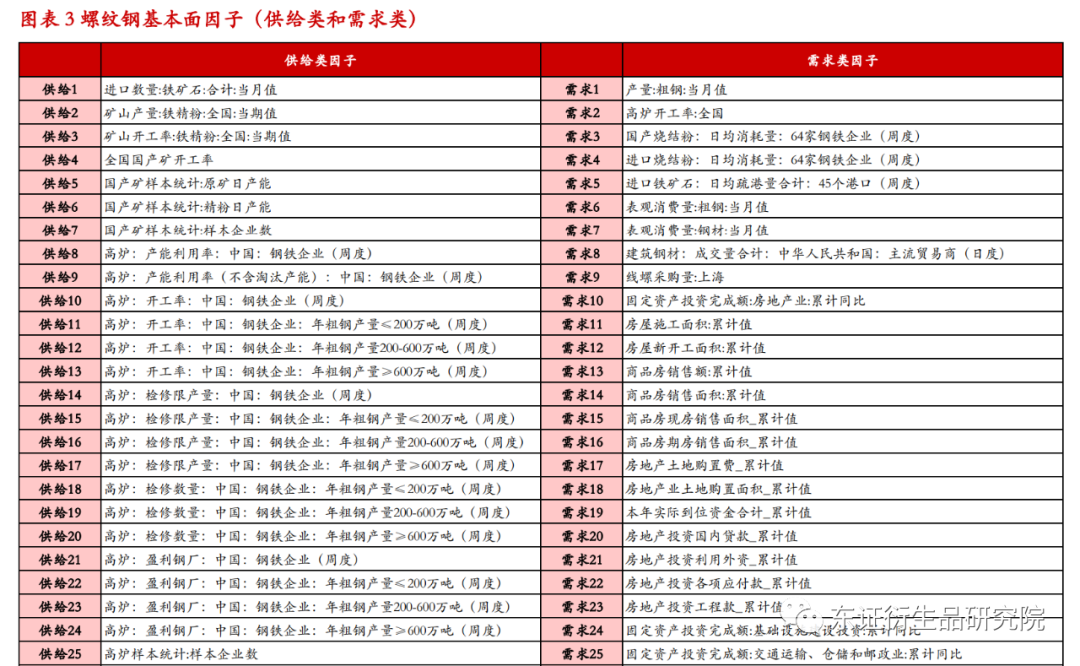
根据螺纹钢产业链的上下游关系,选取相应的基本面数据作为模型的输入因子。螺纹钢是整个钢铁产业最主要的制成品之一。钢铁行业的上游主要涵盖采选(焦煤)、焦化(焦炭)以及黑色金属矿采选(铁矿石)三个行业,中游是黑色金属冶炼及压延,下游则是各种轧钢制品的应用。本报告根据螺纹钢的上下游产业链关系,选取三大类因子,分别是:供给类因子(进口铁矿石数量,高炉开工率,产能利用率,按产能开工率等),需求类因子(房屋新开工面积,房地产投资国内贷款,汽车产量,汽车销售量等),以及库存类因子(铁矿石库存,铁精粉库存,烧结粉库存等)。
除此之外,以螺纹钢为首的黑色系商品与国内宏观经济关系密切。尤其是近年来,钢铁产业链日趋金融化,与其他大类资产的相关性增强,基于此基础上,本报告还整理了宏观数据作为宏观类因子(活期存款利率,宏观经济景气指数,PMI,社会融资规模等)。
以上四大类因子共计121个指标,其中产业相关数据均经过筛选取自于专业钢铁行业数据供应商,宏观相关数据取自万得。
在利用基本面数据进行预测之前,首先对数据进行PCA降维,去除冗余的数据信息,接下来分别采用OLS,XGBoost以及RNN模型对数据进行回归处理,获取价格预测数据。此外,对于XGBoost模型,尝试利用动态特征选择的方式对模型进行改进。最后,通过等权合成以及“少数服从多数”的方式结果多个模型的预测结果建立综合预测模型。
报告采用主成分分析法(PCA)进行降维处理,PCA通过线性变换将原始数据变换为一组各维度线性无关的表示,可用于提取数据的主要特征分量,常用于高维数据的降维。其算法步骤如下:
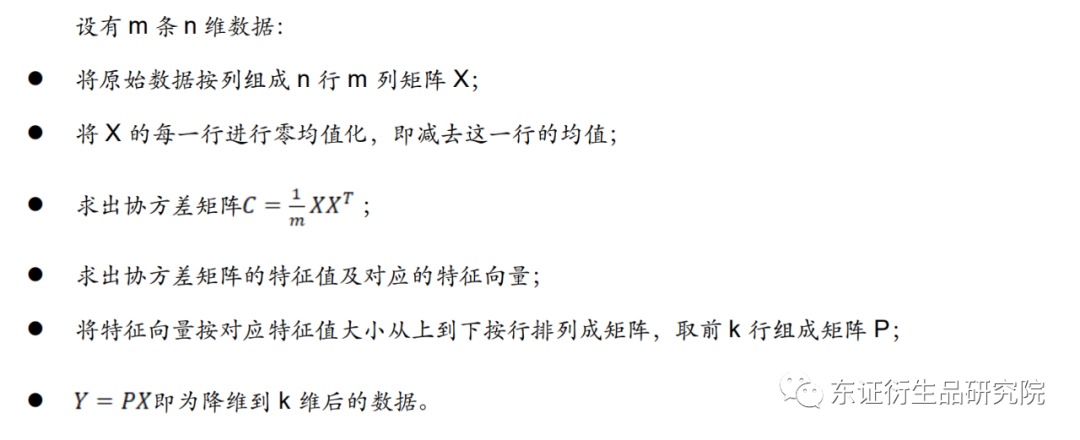
在进行PCA降维之后,可以缓解维度灾难,并对数据进行降噪,同时将数据压缩到低维之后,使得降维之后的数据各特征相互独立。但是在另一方面,由于PCA保留了主要信息,舍弃了一些看似无用的信息,但这些“无用信息”只是在训练集上没有有效表现,因此产生了过拟合的可能性,这一问题在模型训练时需要注意。
频率调整:基本面的原始数据多为低频数据(月频或周频),为便于处理,将所有数据前值填充为日频数据;
标准化:对所有填充后的数据进行z-score标准化处理,提高数据之间的可比性;
异常值处理:对所有偏离均值3个标准差的数据进行处理;
移仓换月处理:为避免期货展期导致的价格影响,本报告以螺纹钢复权价格进行回测;
周期性影响:为剔除数据的周期性影响,对数据进行差分处理;
可得性处理:按指标具体可得性进行相应滞后处理;
回测参数:本报告基于日频数据生成周频级别的多空信号,每周更新仓位,手续费设置为双边万三。
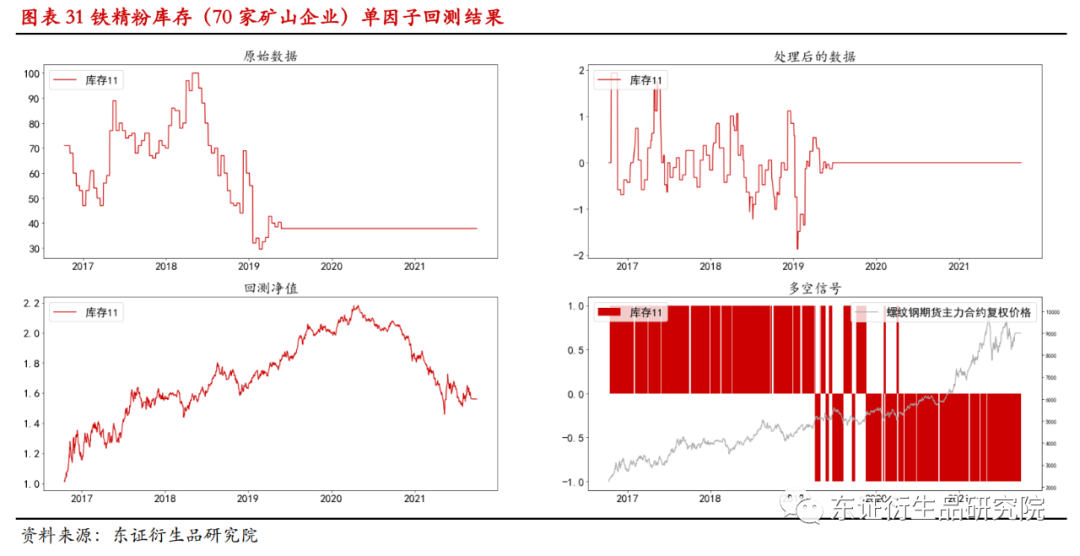
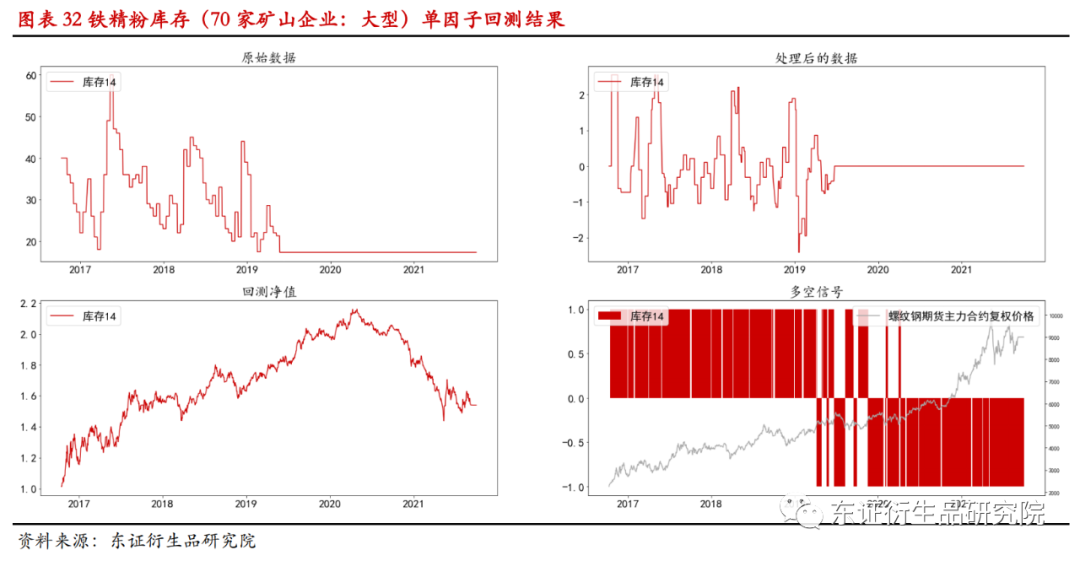
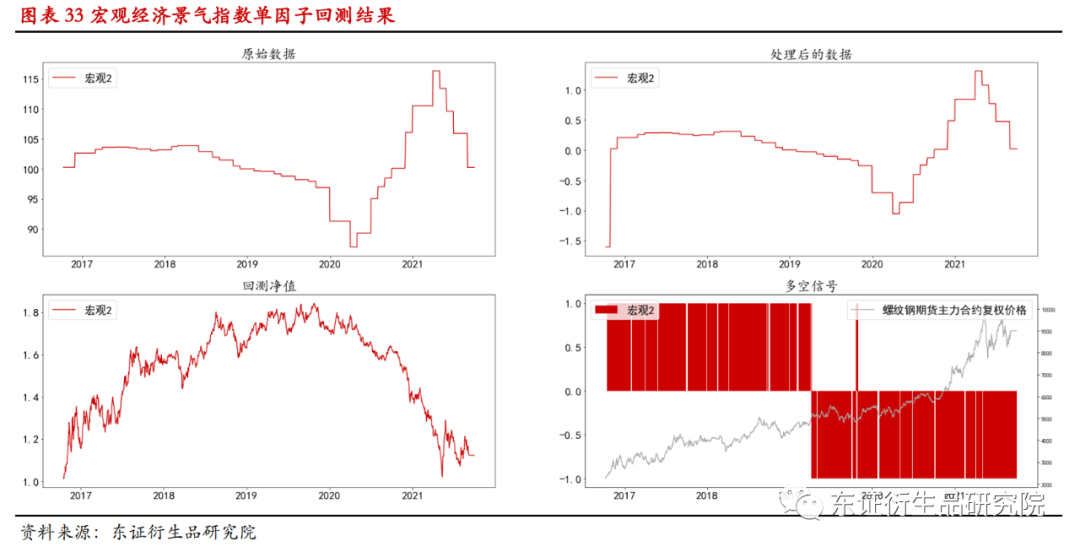
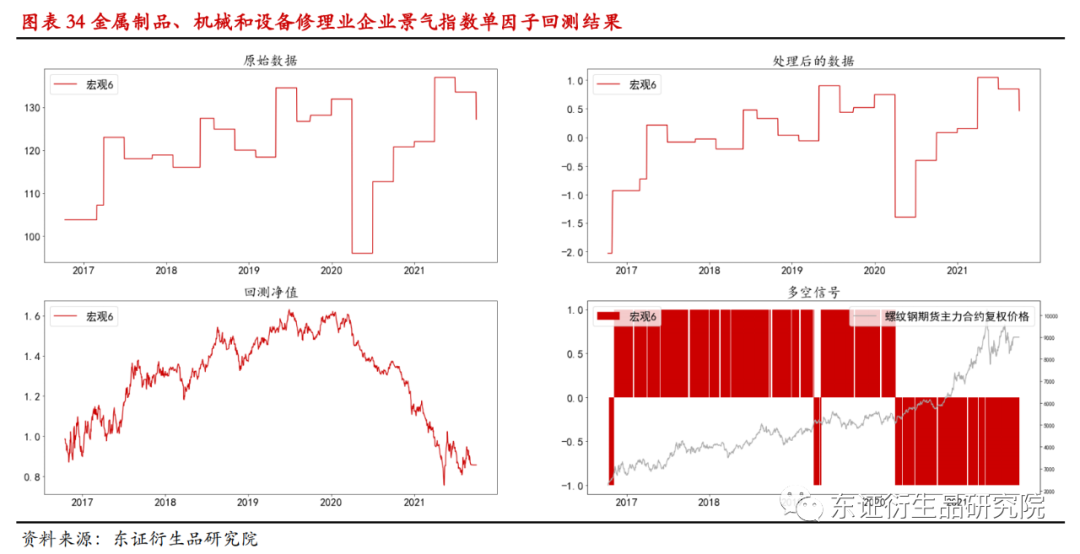
针对所有单因子进行OLS回归,预测未来一周的螺纹钢价格,根据该价格进行多空交易,由此生成回测结果。下图为单因子回测结果展示,由于篇幅限制,只展示收益率前10和后10的因子,在本文附录部分列出了部分单因子的回测曲线。结果显示,大部分单因子的年化收益在20%以下,夏普值低于1,而由于基本面数据多为低频数据(周频或月频),故单因子的平均持仓时间较长,普遍达到30天以上。
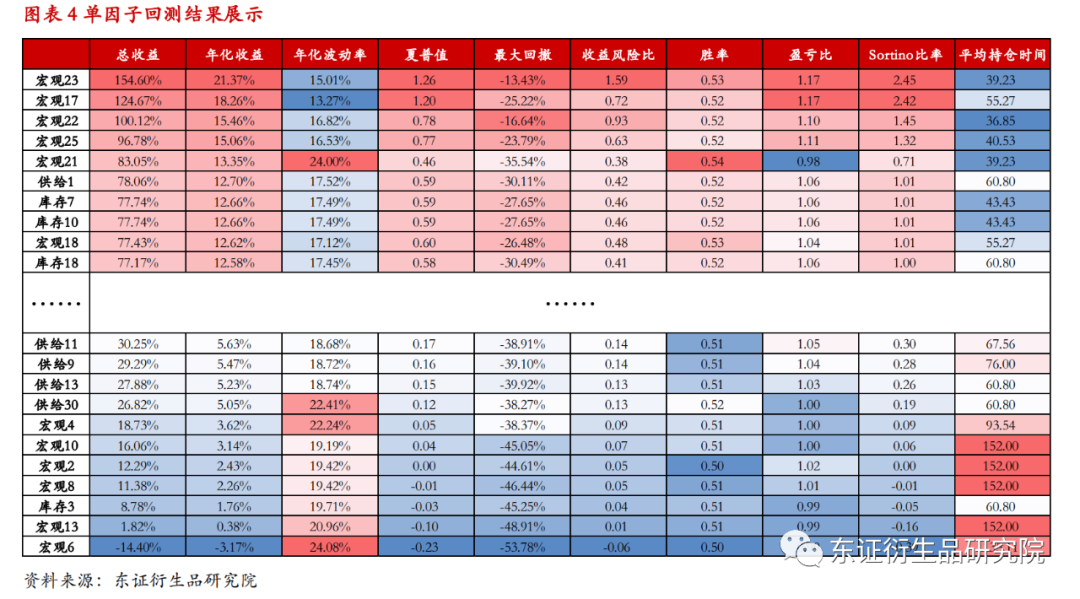
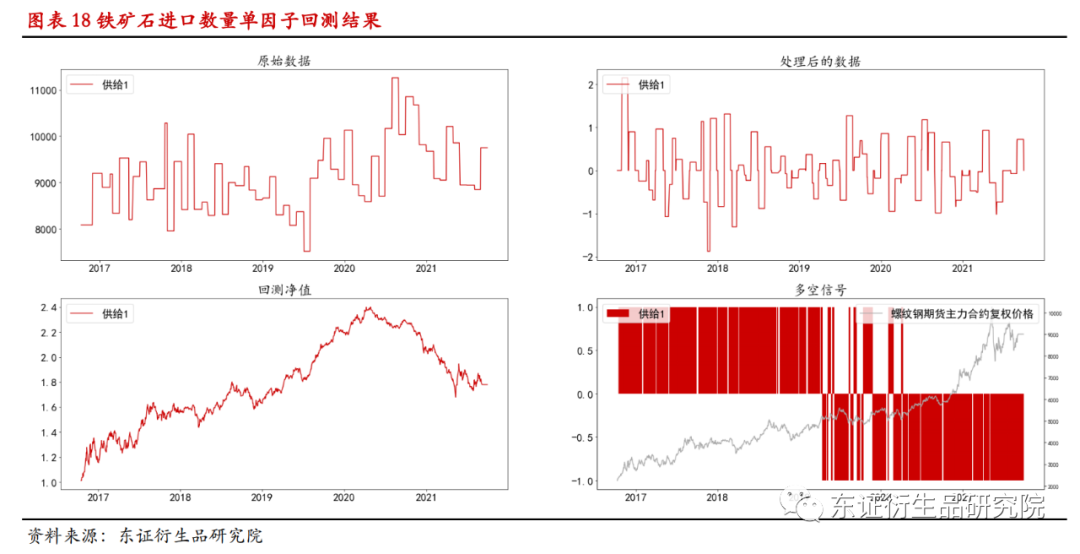
在上表中,可以观察到排名前列的因子多为宏观因子。通过计算四大类因子的平均回测指标发现,显然宏观类因子的平均表现好于其他三类因子,这一现象也体现了螺纹钢与某些宏观经济因素的紧密连接。另一方面,在表现较差的10个单因子中,也存在较多的宏观因子,说明只有部分宏观因子对螺纹钢期货价格具有较好的预测能力。此外,供给1(铁矿石进口数量),库存7(巴西铁矿石库存),库存10(巴西矿港口库存),库存18(全国钢铁企业进口库存)等因子也具有较好的表现。
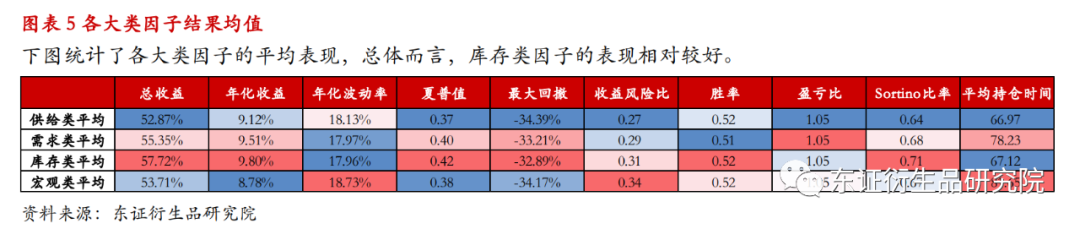
接下来,对各个大类内部因子的预测结果进行等权合成,观察其回测结果。
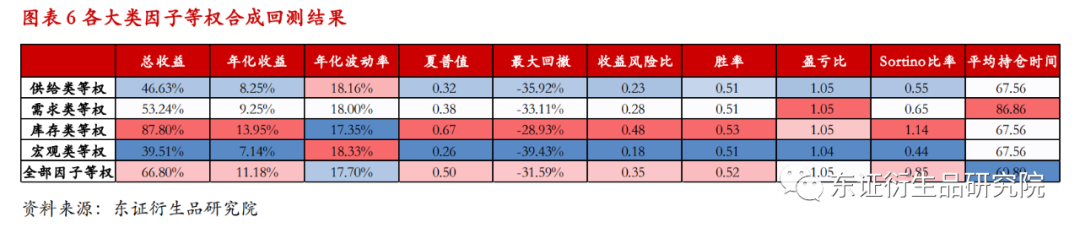
通过上表发现,对预测结果进行等权合成并不会显著提升回测结果。在四大类因子等权合成的结果中,只有库存类因子等权合成的回测结果好于其大类平均值。
在该部分,针对各大类因子进行多元回归,观测其回测结果。OLS(普通最小二乘法)多元回归的原理为,最优拟合曲线应该使各点到直线的距离的平方和(残差平方和RSS)最小:
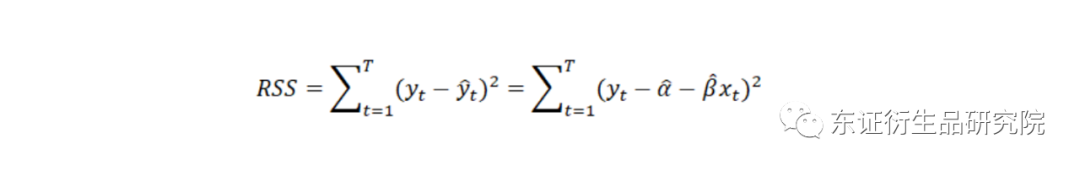
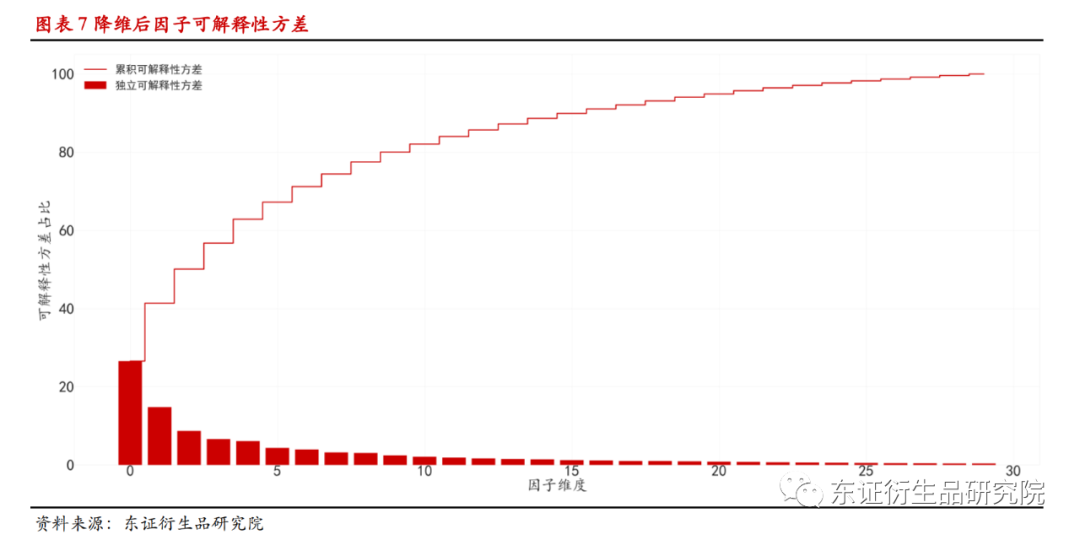
在进行多元回归之前,需要对数据进行降维,通过计算因子的可解释性变量,截取95%的信息度。在信号处理过程中,有效信号具有较大方差,而噪声具有较小方差,信噪比就是信号和噪声的方差比,该值越大越好。为了确定PCA降维的维度数量,需要计算可解释性方差,即将各个特征值大小除以求和的总特征值得到各个特征重要性占比。通过累计可解释性方差,截取95%的信息度,截取得到的维度数量为30个,表明前30个主成分包含了所有特征95%的信息。
利用经过降维后的30个特征对螺纹钢价格作多元回归,最后得到的模型表现为:2017年至今累计收益率127.21%,年化收益率24.15%,年化波动率15.23%,夏普值1.43,最大回撤-13.13%,胜率54.68%,平均持仓时间17.67天。通过OLS多元回归之后的策略表现明显好于之前的单因子策略,收益率以及策略稳定性都得到了较大的提升,另一方面,平均持仓时间也相应缩短了。
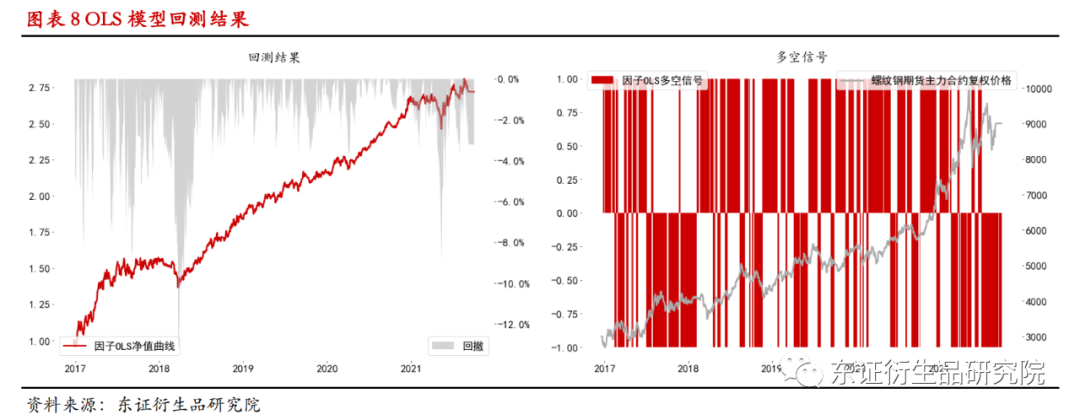
相对于单因子预测,OLS多元回归包含了更多的基本面因子的信息,因此其回测结果更加稳健。其中两次比较大的回撤出现在2018年第一季度和2021年第二季度,比对期货合约主力价格可以发现,这两个时间节点螺纹钢期货价格出现比较大的波动。因此,可以认为OLS固然相对于单因子模型表现更为优秀,但面对大波动的行情时,依然无法做到有效预测。接下来,尝试用非线性模型进行预测,看看效果如何。
XGBoost是基于boosting集成方法的一种集成学习算法,相较于传统的梯度提升树(GBDT)模型,XGBoost在性能和效果上均有明显的提升。作为一个加法模型,XGBoost的基模型一般选择树模型,但也包括逻辑回归等类型。XGBoost模型的两大改进在于目标函数泰勒展开到了二阶,并且加入了叶子权重的L2正则化项,XGBoost模型的目标函数为:
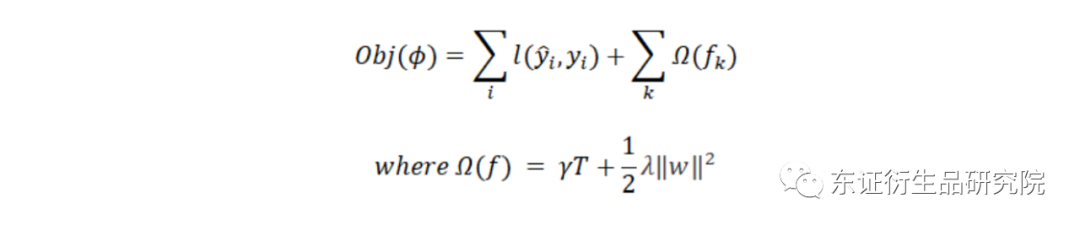
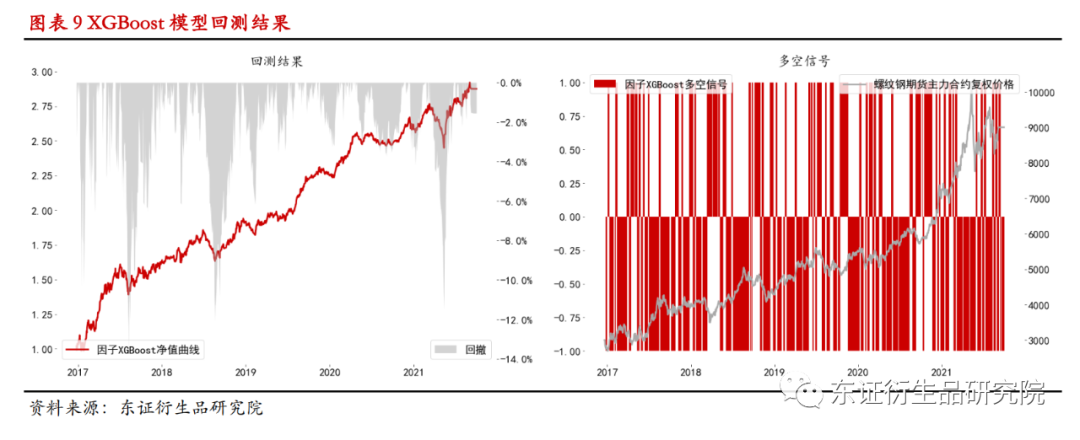
同样利用降维后的特征进行XGBoost模型训练,得到的结果显示:2017年至今累计收益率187.57%,年化收益率25.64%,年化波动率14.92%,夏普值1.56,最大回撤-13.59%,胜率55.10%,平均持仓时间11.54天。可以发现XGBoost的训练结果相对于OLS有一些提升,但是提升幅度较小,并未达到预期,尤其是在今年上半年出现了较大的回撤。考虑到随着市场行情的变化,各个特征的有效性也在不断变化,为了进一步考虑到特征的动态变化,接下来尝试使用特征动态选择的方式作XGBoost模型训练。
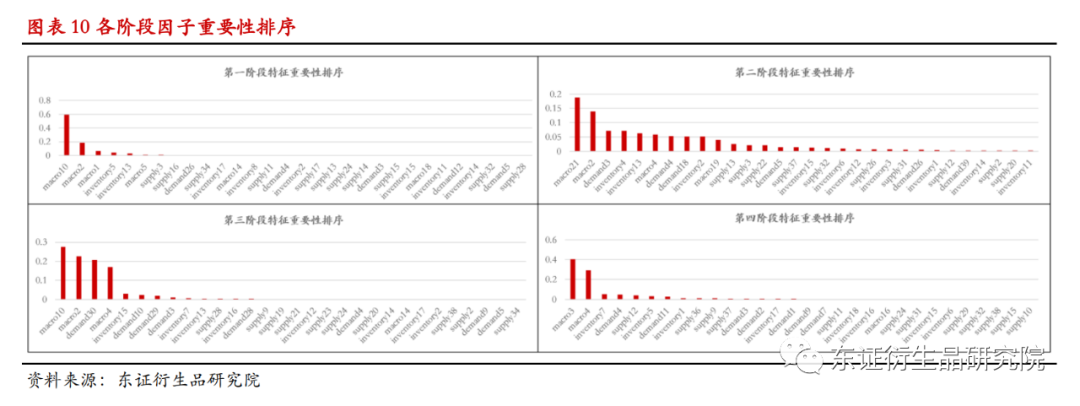
针对未被降维的基本面信息,将总回测时段(共1215个交易日)均分为5个时段,每个时段包含约243个交易日(大致对应一个自然年的交易日)。在每个时段结束之后,统计该阶段重要性最大的30个特征,作为下个阶段的输入特征。此处选择30个特征是因为之前使用PCA降维后得到的维度数量为30,因此采用同样的特征数量,方便进行对比。下图显示了前四个阶段的特种重要性排序,将第一阶段的重要特征作为第二阶段的输入特征,以此类推,而第一阶段则采用PCA降维后的特征,这一操作也是为了和前述模型进行对比。
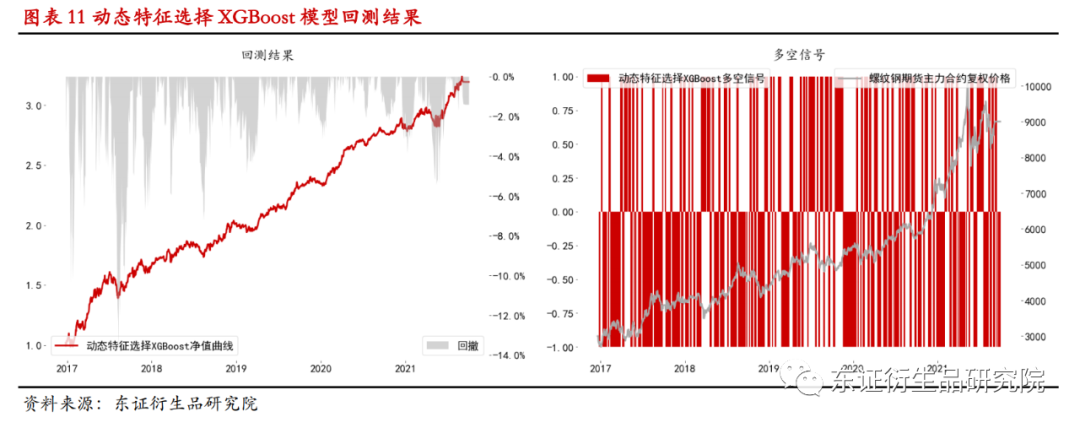
经过模型训练,得到的结果显示:2017年至今累计收益率219.21%,年化收益率28.51%,年化波动率14.54%,夏普值1.80,最大回撤-13.59%,胜率55.96%,平均持仓时间9.18天。对比可得,采用动态特征选择之后的XGBoost模型有了更好的回测效果,收益率和夏普值都得到了明显的提升,相应的,平均持仓时间也进一步缩短了。此外,对比两者的回撤图,可以发现,未采用动态特征选择的XGBoost模型在今年上半年的大级别行情下有较大的回撤,而采用动态特征选择的XGBoost模型则有效减少了该时段的回撤。因此可以初步认为,采用动态特征选择的XGBoost模型能够更加有效地应对较大级别的价格波动。
RNN(Recurrent Neural Network),又称循环神经网络,是一类用于处理序列数据的神经网络。基础的神经网络包括输入层,隐藏层,输出层,并通过激活函数控制输出,层与层之间通过权值连接,而RNN 在此基础上,对层之间的神经元也建立了权连接,基于此,RNN便具有了记忆功能。
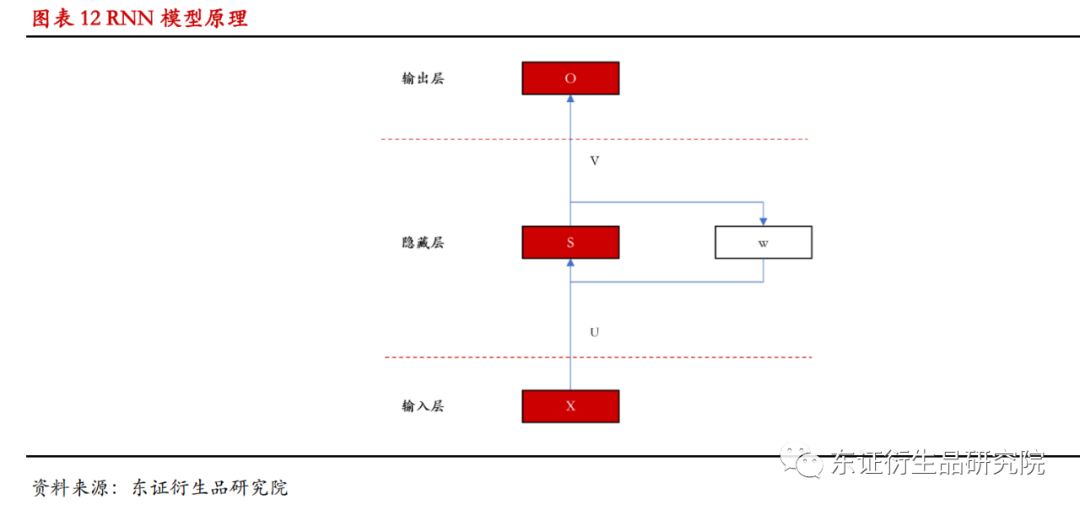
上图显示,U是输入层到隐藏层的权重矩阵,V是隐藏层到输出层的权重矩阵。循环神经网络中隐藏层的值S不仅仅取决于当前这次的输入X,还取决于上一次隐藏层的值S,权重矩阵 W就是隐藏层上一次的值作为这一次的输入的权重,因此RNN网络对上一时刻的隐藏层具有记忆功能。
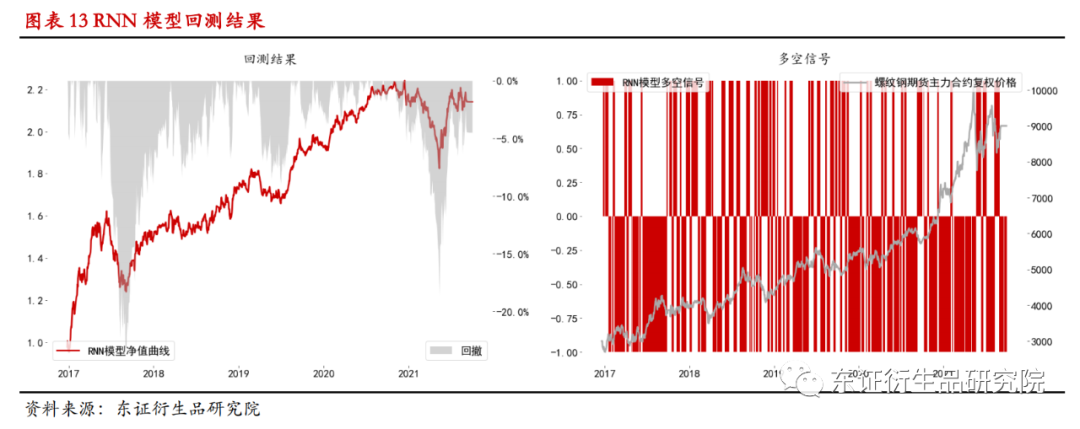
然而传统的RNN会遇到的一个问题是后面时间的节点对于前面十点节点的感知力下降。于是在RNN记忆模型中再加入遗忘门,输入门和输出门,使得可以记忆更加长期的信息,这就是LSTM(长短期记忆)模型,LSTM是一种特殊的RNN模型。遗忘门(forget gate)在LSTM中一定的概率控制是否遗忘上一层的隐藏细胞状态;输入门(input gate)负责处理当前序列位置的输入,确定什么样的新信息被存放在细胞状态中;输出门(output gate)则对更新后的细胞状态进行输出。本报告使用LSTM模型进行训练,得到的结果为:2017年至今累计收益率114.06%,年化收益率17.87%,年化波动率15.80%,夏普值0.98,最大回撤-23.51%,胜率53.82%,平均持仓时间12.40天。可以发现,RNN的训练结果并没有OLS和XGBoost有效,一部分原因在于RNN属于深度学习模型,需要较大的数据量,本报告基于低频的基本面数据生成周频级别的信号,即使已经将数据填充至日频数据,仍然只用千量级的数据,导致训练结果并不有效。
行文至此,我们已经有了四个模型的预测结果了,分别是OLS,XGBoost,特征选择XGBoost,以及RNN模型。不妨将这四个模型结果进行合成,得到一个综合模型,于是按照一定的权重分别对各个模型赋值,观测回测结果。篇幅所限,本报告并未讨论所有可能的合成组合,但下文所列出的合成组合已经能够充分展示综合模型的预测能力。
下面两张图依此展示了OLS分别与XGBoost和特征选择XGBoost的合成结果。
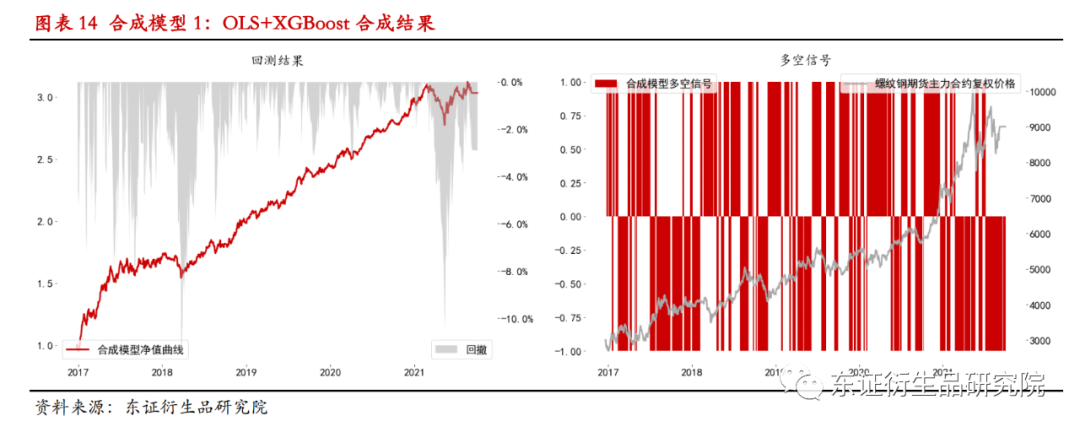
结果显示,合成模型1的回测表现为:2017年至今累计收益率203.20%,年化收益率27.09%,年化波动率14.00%,夏普值1.76,最大回撤-11.38%,胜率55.45%,平均持仓时间16.66天。
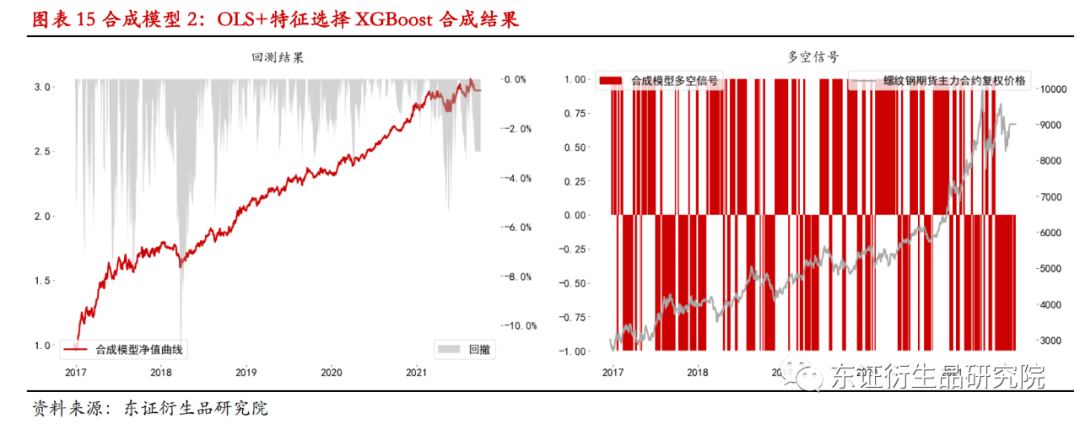
合成模型2的回测表现为:2017年至今累计收益率196.93%,年化收益率26.52%,年化波动率13.95%,夏普值1.73,最大回撤-11.03%,胜率55.02%,平均持仓时间15.76天。
合成模型1和合成模型2的回测结果并没有太大差异,但是从回撤图来看,合成模型2在2021年上半年的行情中回撤更小,这与特征合成XGBoost的特点是一致的,接下来加入RNN模型观察结果。
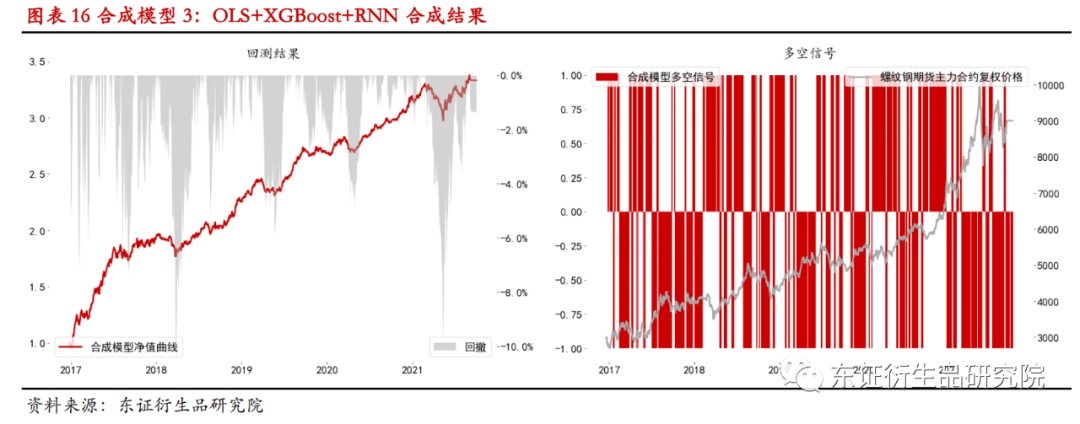
结果显示,合成模型3的回测表现为:2017年至今累计收益率233.53%,年化收益率29.74%,年化波动率13.16%,夏普值2.08,最大回撤-10.07%,胜率56.05%,平均持仓时间14.22天。在加入了RNN模型之后,合成模型的回测结果得到进一步提升。
除了等权合成的方式,还可以利用“少数服从多数”的信号输出机制。根据OLS,XGBoost,RNN三个模型的多空信号输出,根据少数服从多数的原理进行合成
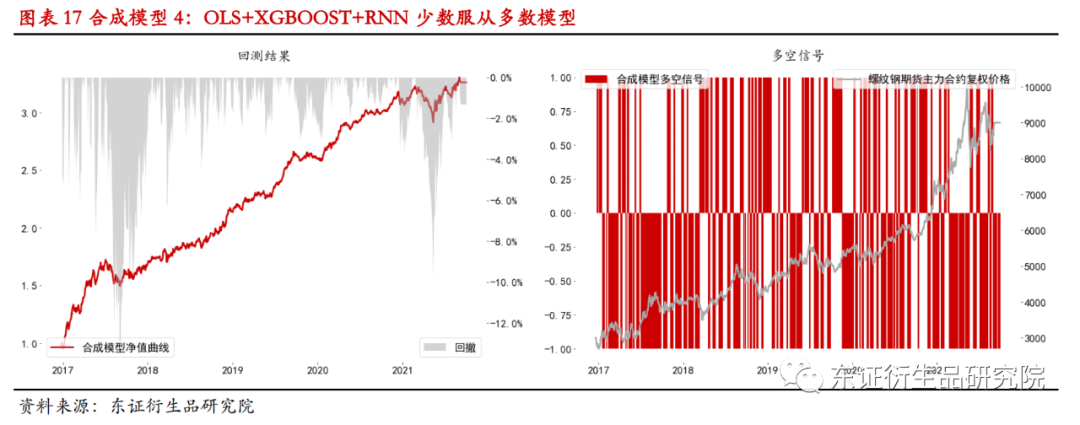
结果显示,合成模型4的回测表现为:2017年至今累计收益率226.24%,年化收益率29.11%,年化波动率13.62%,夏普值1.96,最大回撤-13.25%,胜率56.05%,平均持仓时间11.43天。总体而言,“少数服从多数”合成模型与等权模型的差异并不大。
本文利用螺纹钢基本面数据进行多模型价格预测,比较了不同模型之间的效果,最后尝试合成不同模型的预测结果生成综合预测模型。研究发现,XGBoost相对于其他模型,具有较好的预测效果,如果采用动态特征选择的方法,可以更加有效地应对大级别地行情。在合成模型方面,三模型的合成模型好于两模型的合成模型,以合成模型3为例(OLS+XGBoost+RNN等权合成)可以达到超过2的夏普值,同时“少数服从多数”的合成方法相对于等权合成并没有明显提升。
本研究方法仍然存在值得改进之处,除了模型本身的优化之外,还可以尝试与商品分析师合作,对于基本面因子进行人工筛选以及特征构造,这也是我下一步预备的研究方向。
在模型的泛化方面,期待在模型得到更多验证之后,构建全品种的预测模型,在横截面和时间序列都能生成交易信号。
市场风格的变换会造成特征有效性变化,导致模型效果下降。
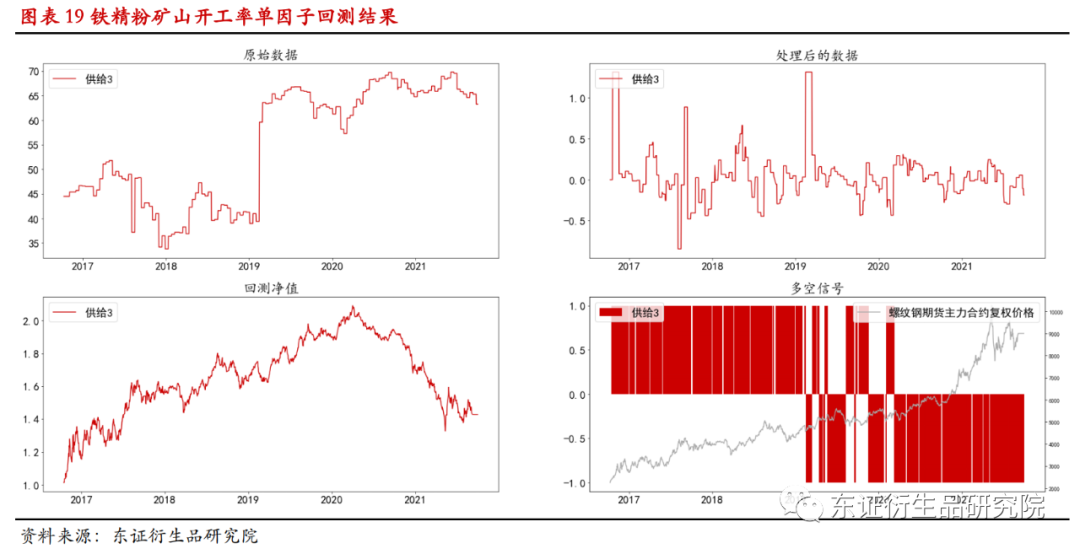
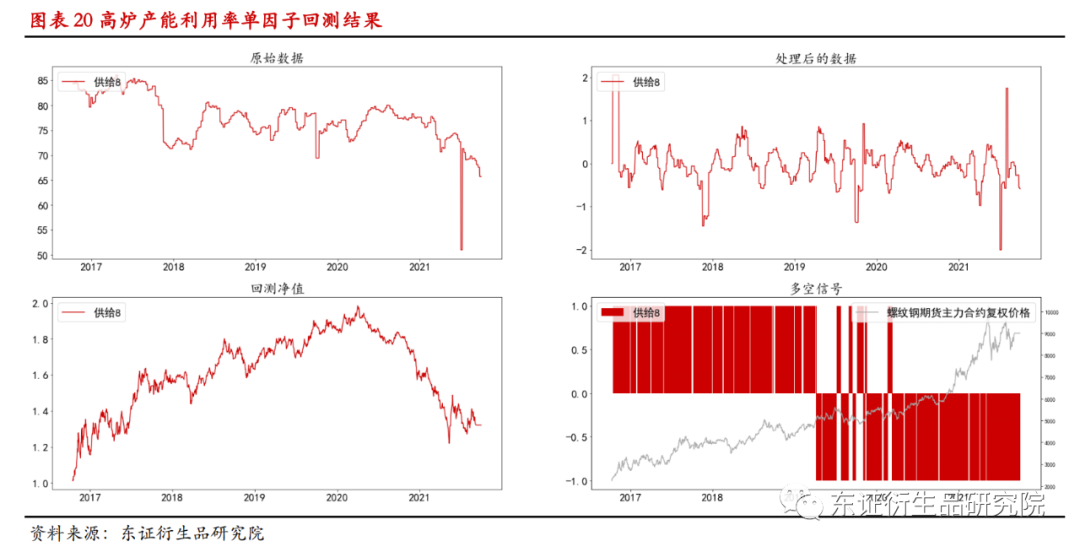
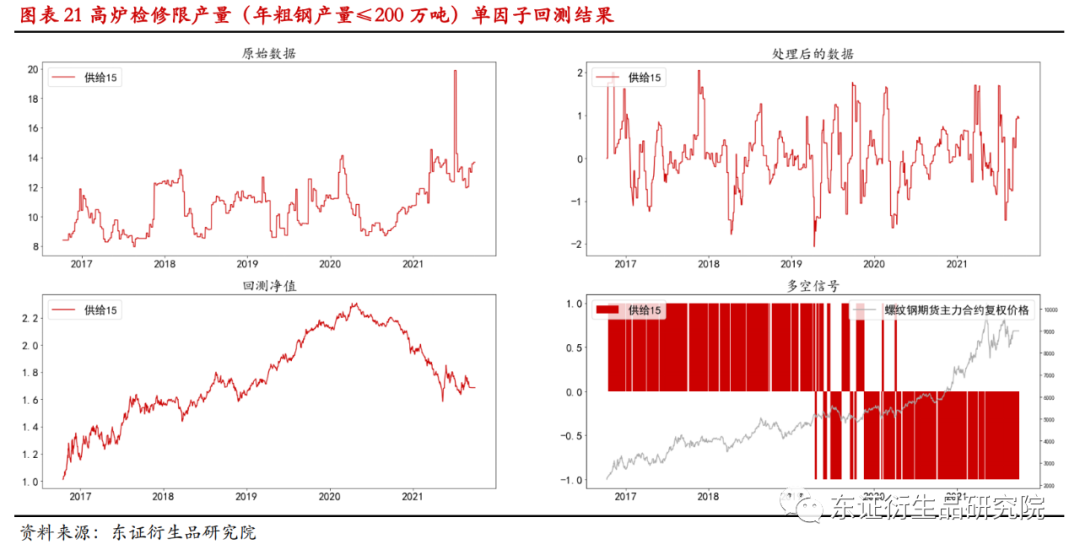
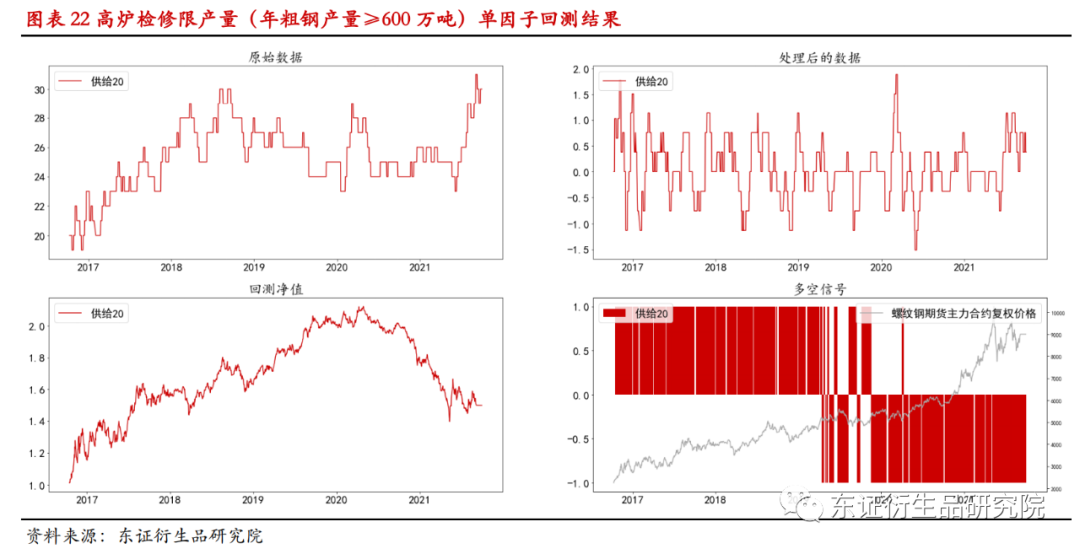
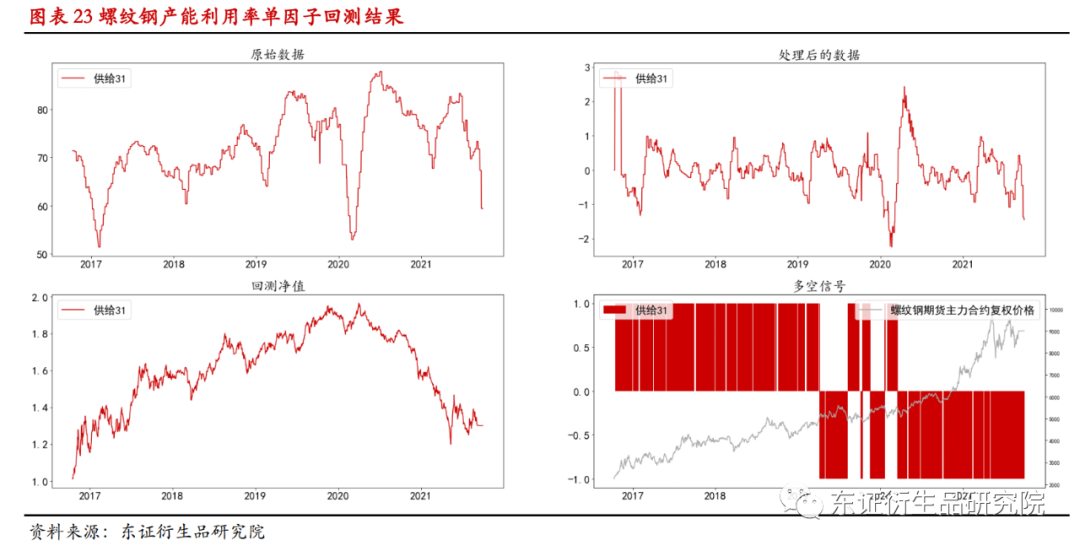
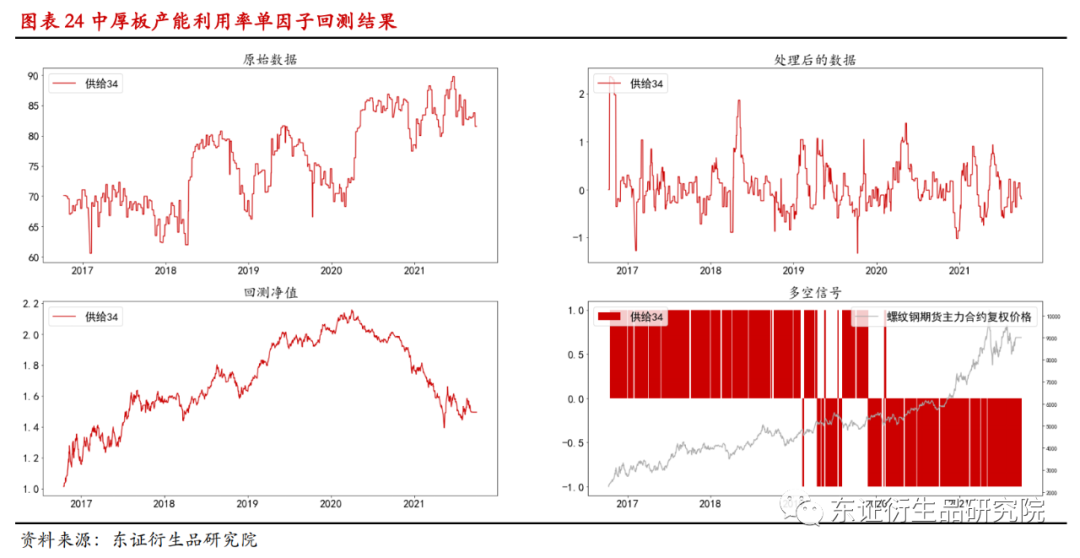
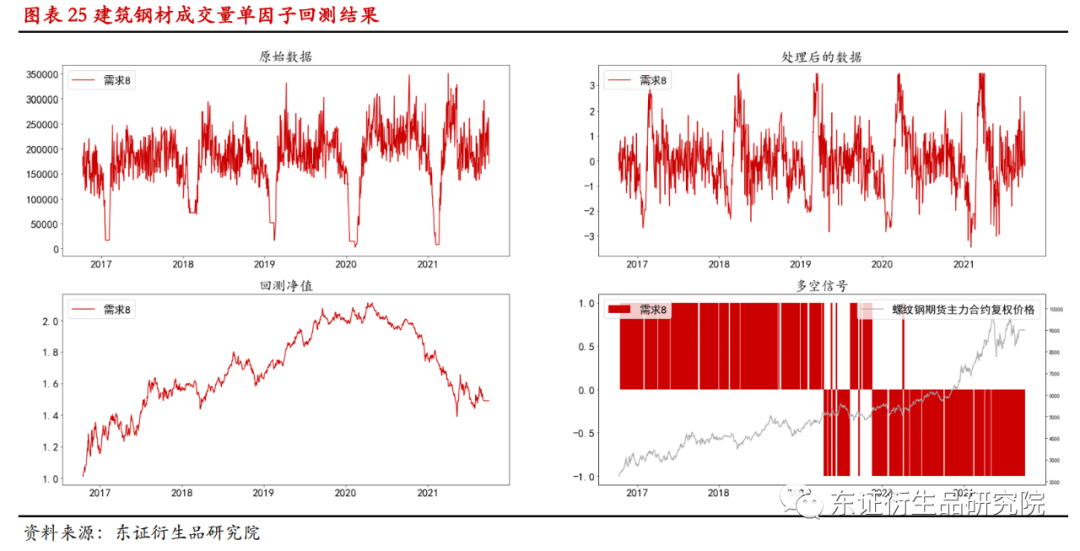
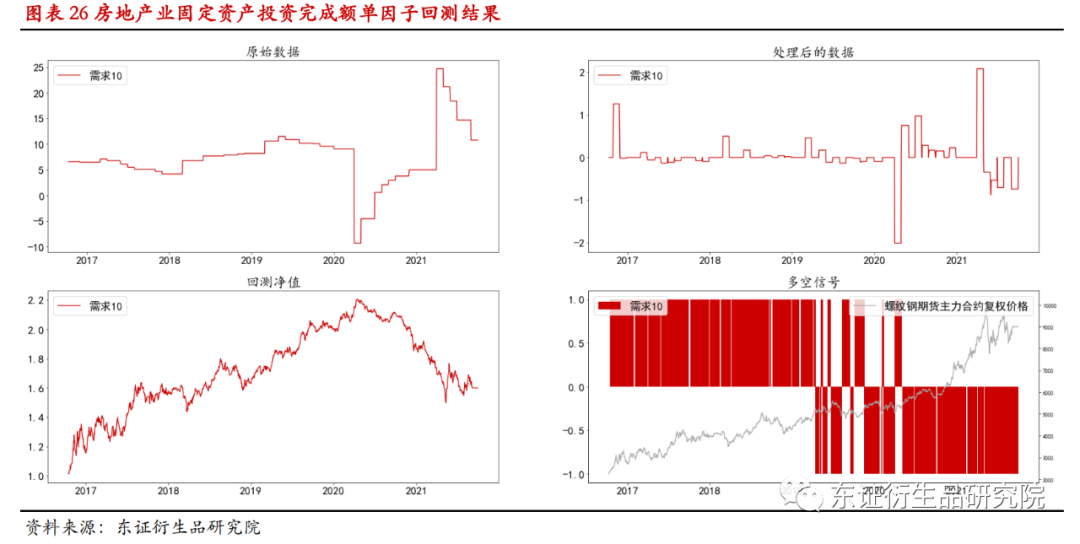
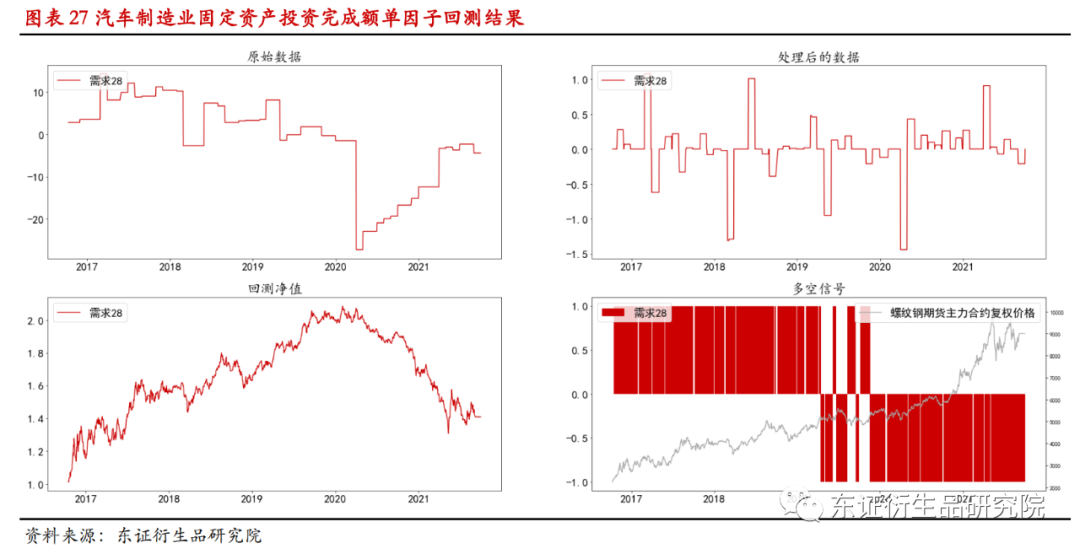
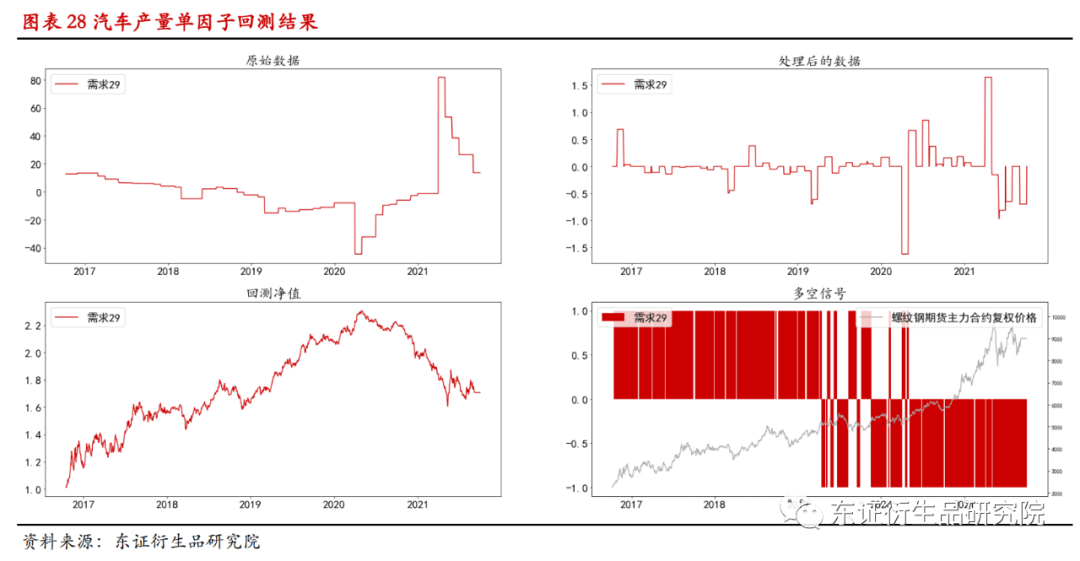
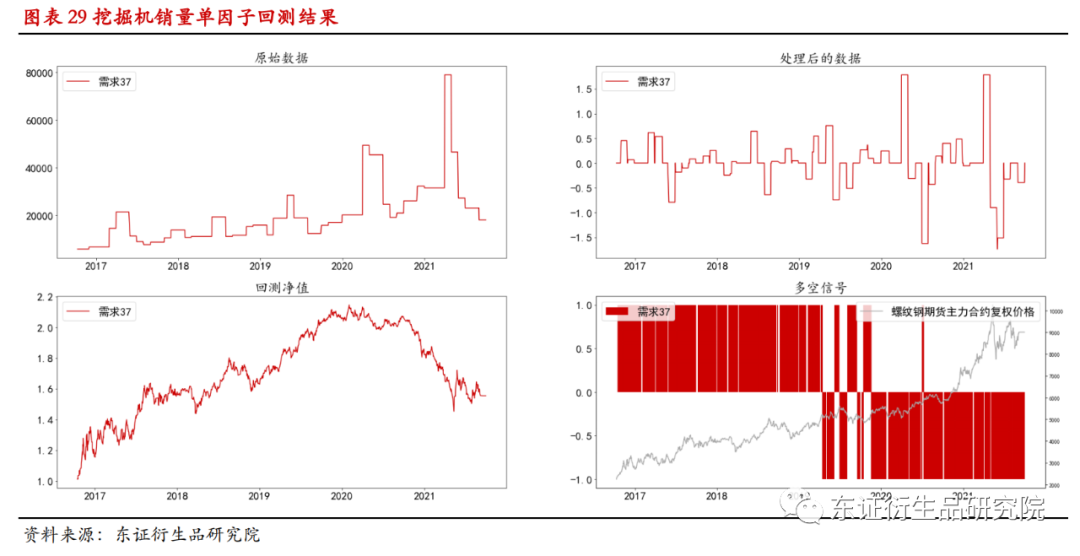
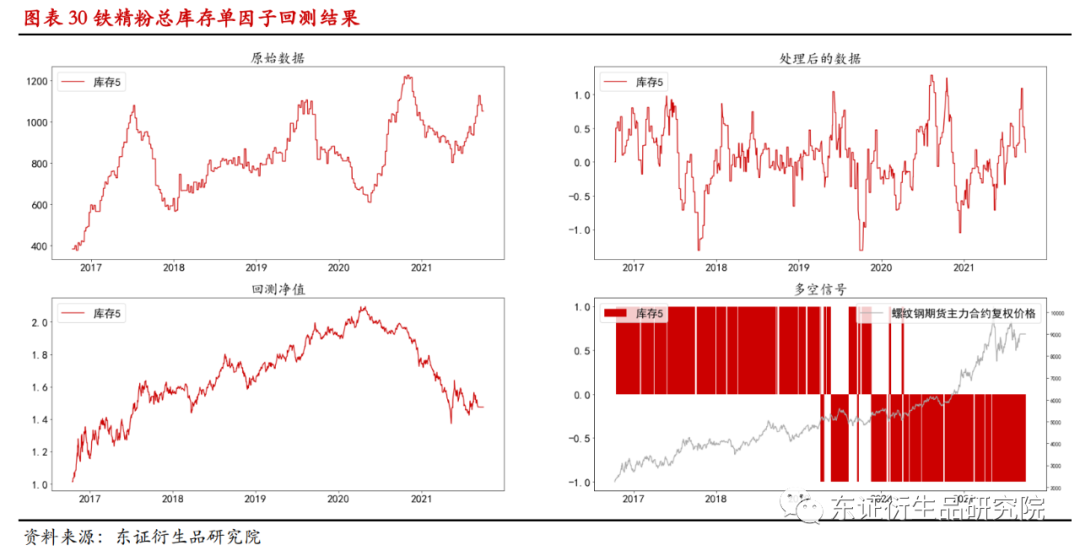
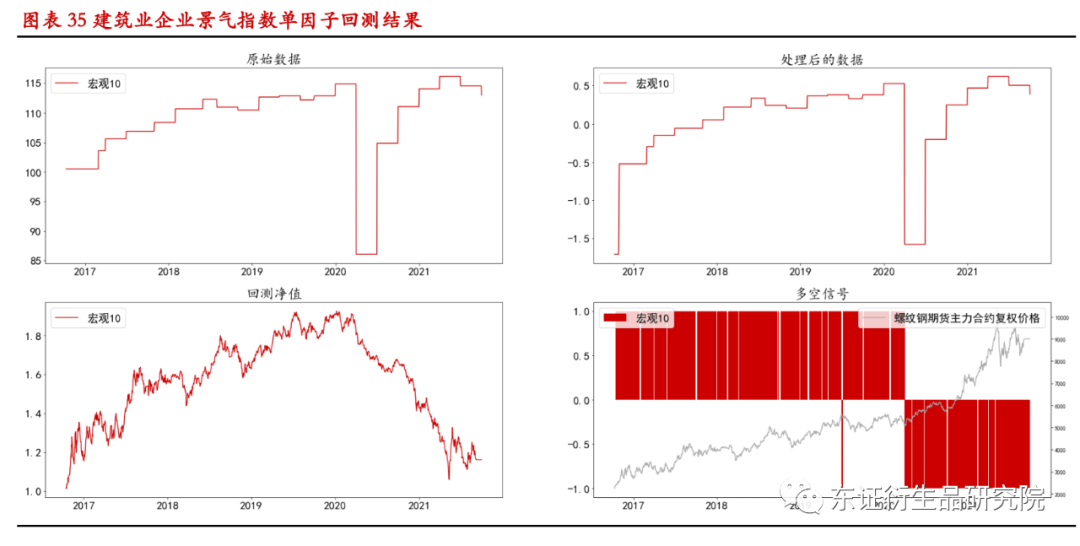
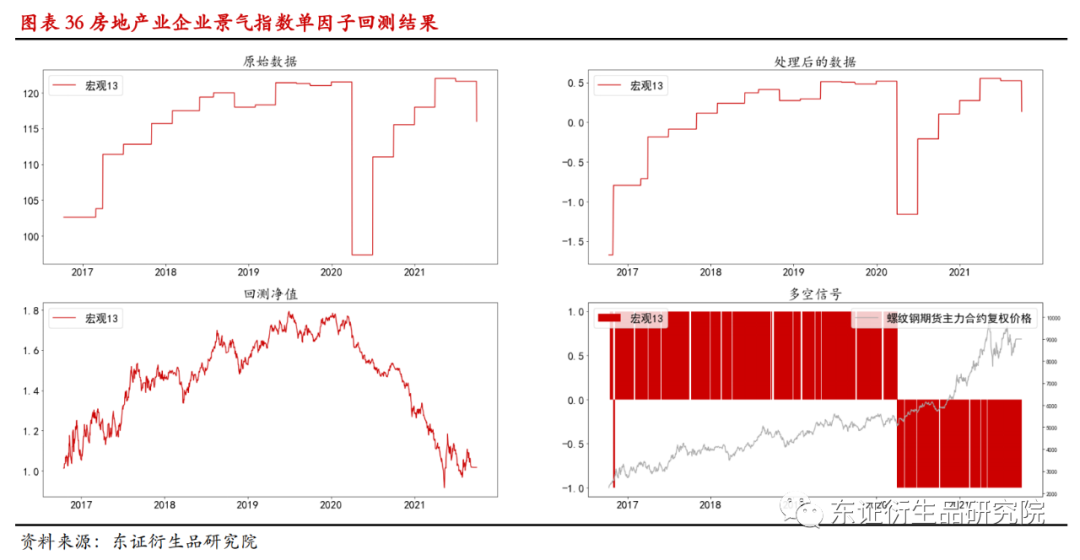
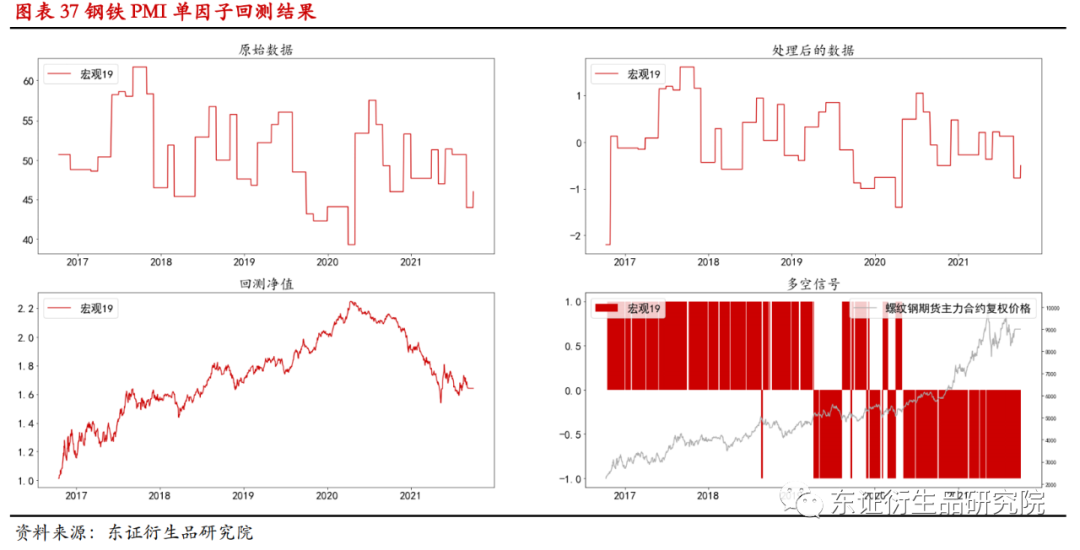
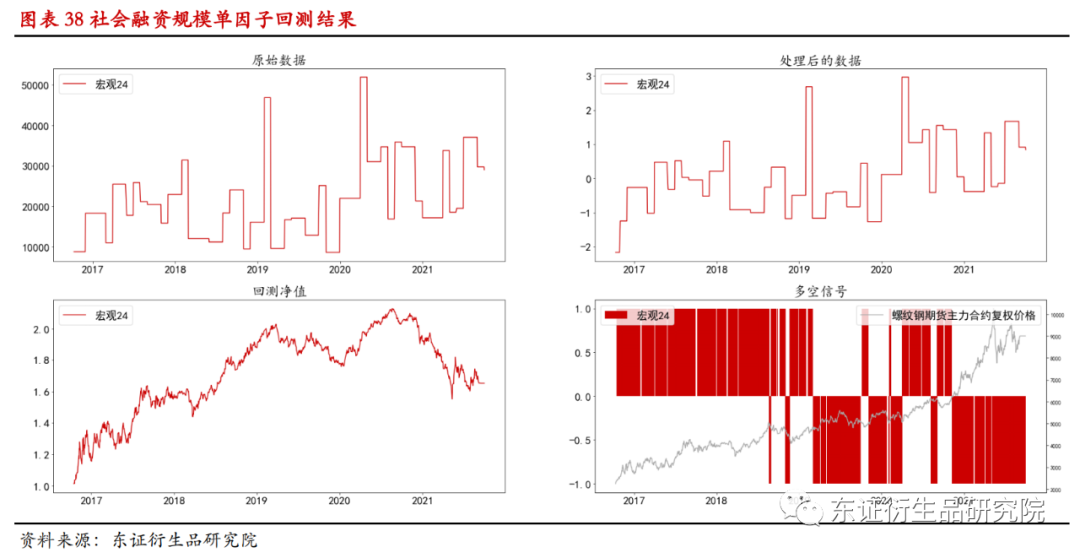
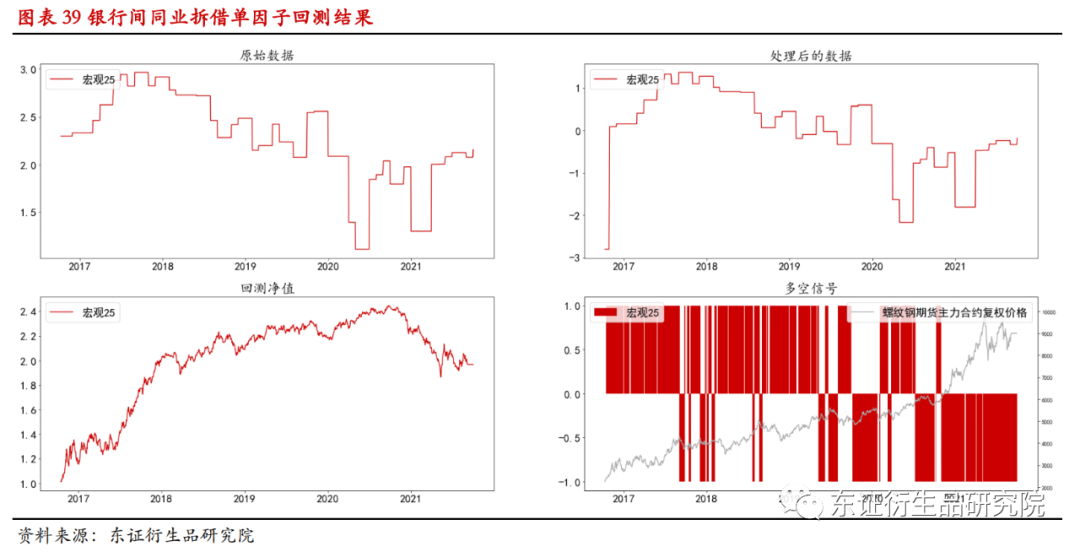
在附录中给出部分因子的回测结果,包括原始数据(左上图),处理后的数据(右上图),回测净值(左下图),以及多空信号(右下图)。
王冬黎 高级分析师(金融工程)
从业资格号:F3032817
投资咨询号Z0014348
Email:dongli.wang@orientfutures.com
联系人
谢怡伦 (分析师)
从业资格号:F03091687

长按二维码关注